Azt vártam, hogy a magyar mezőny technikailag le lesz maradva. Nem így lett. A technikai alapokban nagyjából ugyanott állunk, ahol a nagyok. A különbség egyetlen helyen van, ott viszont brutális: a 14 nemzetközi lap mindegyike kimondta a robots.txt fájljában, hogy melyik AI-bot mit csinálhat a tartalmával. A magyar oldalak 80 százalékánál erről egyetlen sor sincs. Nem tiltás, nem engedés, semmi. Ez a tanulmány erről szól: mit mértem, mi derült ki név szerint, melyik bot tanul, melyik keres, melyik hoz látogatót, és mi az a három döntés, amit minden kiadónak meg kell hoznia.
Összefoglaló annak, aki csak két percet szán rá
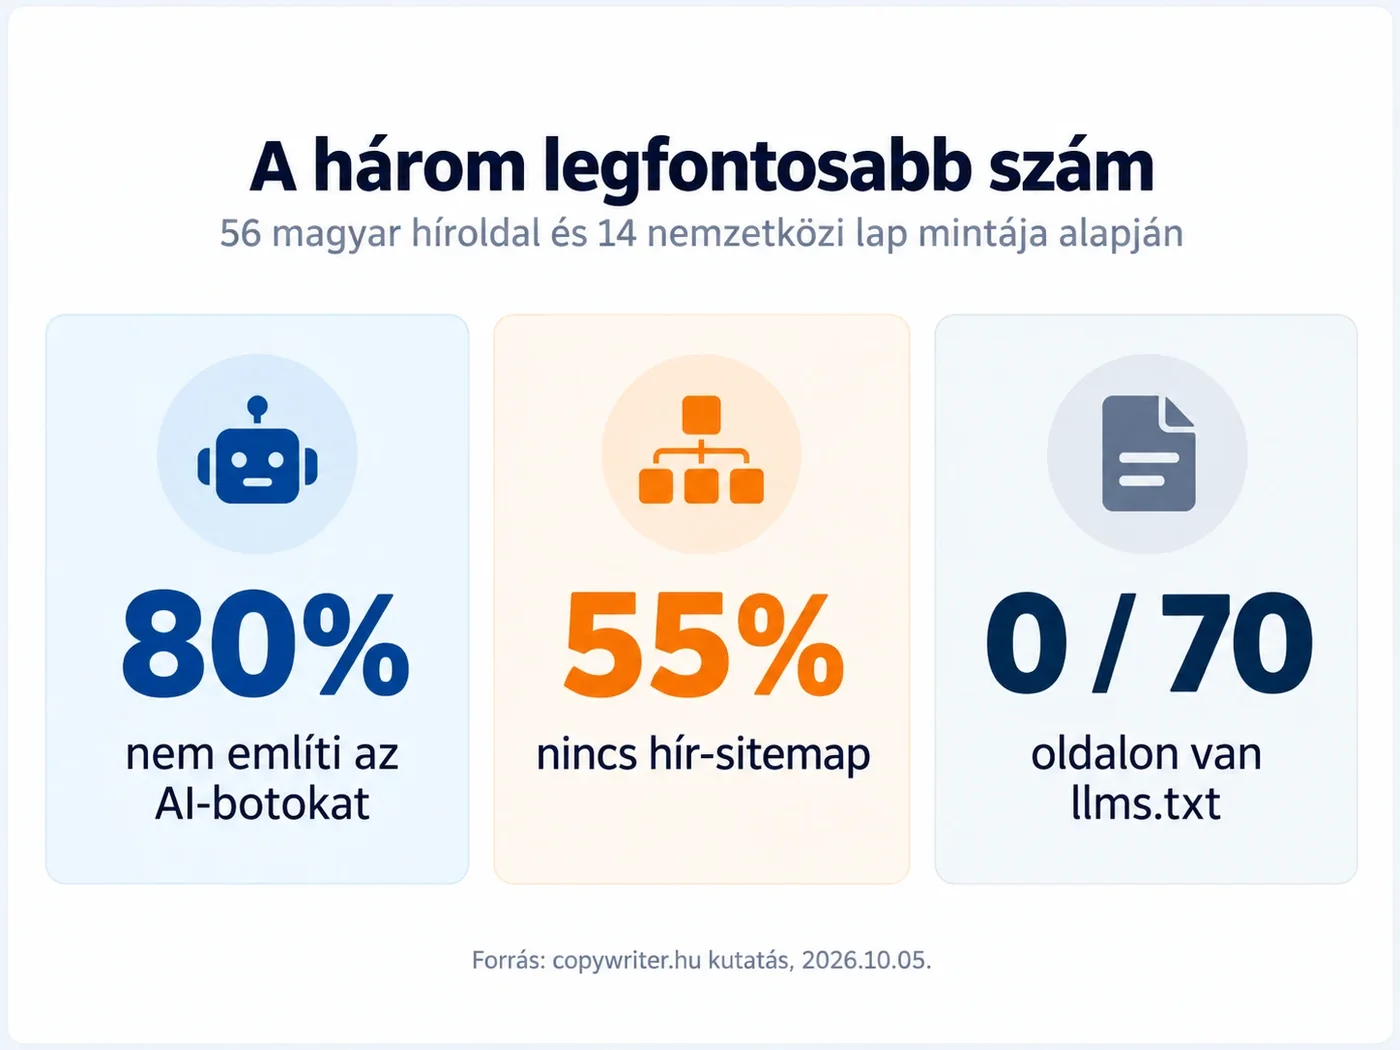
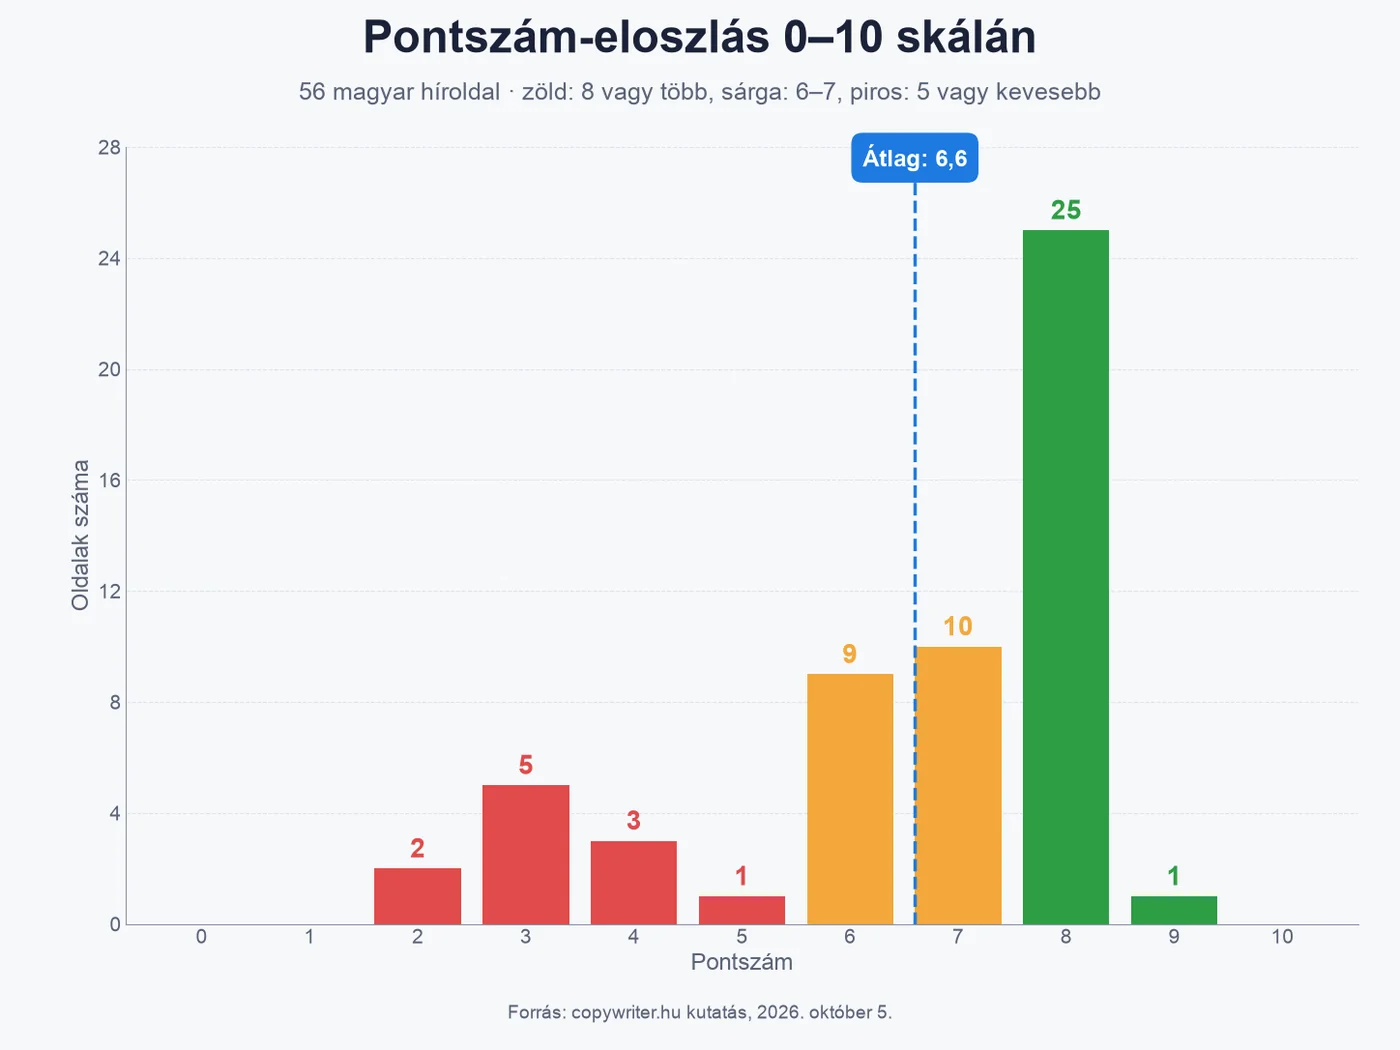
A magyar híroldalak 80 százalékának robots.txt fájljában egyetlen AI-crawlerre sincs szabály, a nemzetközi kontrollcsoportban ez az arány nulla. A magyar oldalak 55 százalékának nincs Google News hír-sitemapja, a nemzetköziek 23 százalékának. Az llms.txt fájlt a 70 vizsgált oldalból egy sem használja, a New York Times sem. A tízpontos skálán a magyar átlag 6,6, a nemzetközi 7,5 (kerekítés előtt 5,54 + 1,92), és a különbség szinte teljes egészében az AI-botokról szóló döntés hiányából jön: technikai alapokban 5,4 és 5,5 pont a hétből, az AI-botok szabályozásában 1,2 és 1,9 a háromból.
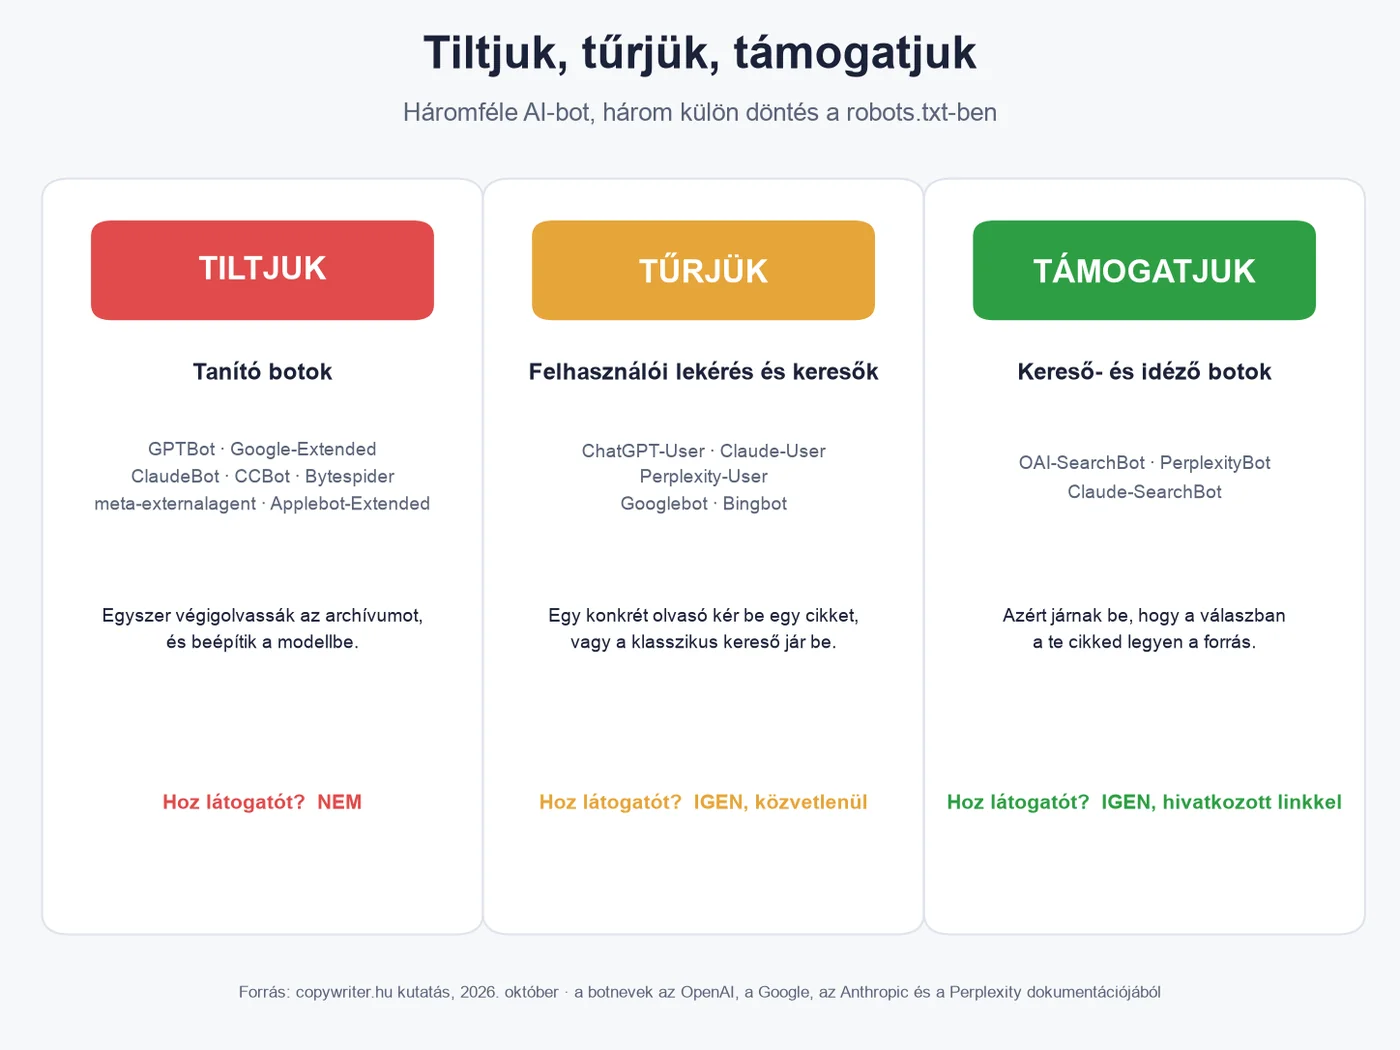
A tanulság nem az, hogy a magyar média technikailag béna. Az, hogy nem döntött. Az AI-botokról három külön döntést kell hozni, mert háromféle bot van: amelyik tanul, amelyik keres és idéz, és amelyik egy konkrét olvasó kérésére kéri le a cikket. Az elsőt tiltjuk, a másodikat támogatjuk, a harmadikat tűrjük. Ez tíz-tizenöt sor a fájlban, és egy félórás megbeszélés a kiadónál.
Mit mértem, és miért pont ezt a hármat?
A robots.txt a web legrégebbi illemszabálya, 1994 óta létezik. Egy szöveges fájl a domain gyökerében, amiben a kiadó megmondja az automatizált bejáróknak, hova léphetnek, és hol találják a sitemapot. 2023 óta van egy új funkciója is: az OpenAI, a Google, az Anthropic és a Meta botjai saját néven jelentkeznek be, így itt lehet jelezni nekik, hogy a tartalmunkból tanulhatnak-e. Fontos a pontos szó: jelezni. Ez hozzáférési preferencia, amit a nagy szereplők a saját dokumentációjuk szerint tiszteletben tartanak. Ma ez az egyetlen széles körben követett jelzés, és aki nem ír bele semmit, az nem mondott semmit.
A sitemap az oldal URL-jeinek XML-listája, az utolsó módosítás dátumával. Híroldalnál van egy külön változata, a Google News hír-sitemap: csak az utolsó 48 óra cikkei, legfeljebb ezer URL, megjelenési idővel és a kiadvány nevével. A Google szerint ez segít neki gyorsan megtalálni és feldolgozni a friss híreket. Garanciát semmire nem ad, a Discoverhez például külön nem is kell, de a leggyorsabb út a friss cikkhez, és ezért a nemzetközi híroldalak alapfelszerelése. A tízéves archívumot pedig a sima sitemapindex fedi le, évenkénti vagy havi részfájlokkal.
Az llms.txt egy 2024. szeptemberi javaslat az Answer.AI-tól: egy rövid Markdown-fájl a gyökérben, ami bemutatja az oldalt a nyelvi modelleknek, kontextusablakba férő méretben. Dokumentációs oldalakon terjedt el. Híroldalon, mint látni fogod, sehol. Erről külön fejezet szól, mert a története tanulságosabb, mint a szám.
Módszertan: tíz kérdés, két csoport, egy délután
A mérés 2026. október 5-én készült, egyetlen menetben, asztali böngésző user-agenttel, Budapestről. Minden oldalon lekértem a robots.txt-t, a szabványhelyen lévő /sitemap.xml-t, a robots-fájlban deklarált sitemapokat (legfeljebb négyet), húsz gyakori alternatív sitemap-útvonalat ott, ahol semmi nem válaszolt, valamint az llms.txt, llms-full.txt és ai.txt fájlokat. A sitemapindexeknél a részfájlokból mintát vettem, ezért az URL-számok alsó becslések, a frissességet viszont a vitás eseteknél (index.hu, forbes.hu, atv.hu, hirado.hu, nyugat.hu, demokrata.hu) a teljes index átnézésével ellenőriztem.
A mintába 56 magyar oldal került: országos hírportálok, gazdasági lapok, bulvár, regionális Mediaworks-lapok, két határon túli magyar portál és néhány nagy magazin, amely híreket is megjelenít. Két oldal kiesett, mert megszűnt (azonnali.hu, noizz.hu). A nemzetközi kontroll 14 lap: New York Times, Guardian, BBC, Spiegel, Le Monde, El País, FAZ, Washington Post, Reuters, Zeit, Corriere della Sera, Süddeutsche, Financial Times, Bild. Az AP kiesett, mert minden kérésre 403-at adott. A Washington Post sitemapjait a botvédelem nem adta ki, ezért a sitemap-mutatóknál és a pontszámban nem szerepel, a nemzetközi átlagok 13 lapra vonatkoznak.
Tíz kérdést tettem fel minden oldalnak, mindegyik egy pontot ér. Hét a technikai alapokról szól, három az AI-botok szabályozásáról. Egyforma súlyt kaptak, mert nem akartam, hogy a saját preferenciám rendezze a sort. Így néz ki a lista, mellette a két csoport eredménye:
| Csoport | Kérdés | Magyar (56) | Nemzetközi (14) |
|---|---|---|---|
| Technikai alapok | A robots-fájl elérhető és szöveges | 100% | 100% |
| Technikai alapok | Van Sitemap: sor a robots-fájlban | 71% | 79% |
| Technikai alapok | A robots-fájl szabályos (hibátlan szintaxis, van általános csoport) | 91% | 100% |
| Technikai alapok | Van működő XML-sitemap | 88% | 85% |
| Technikai alapok | A /sitemap.xml szabványhely rendben van | 73% | 54% |
| Technikai alapok | Van Google News hír-sitemap | 45% | 77% |
| Technikai alapok | A lastmod friss (30 napon belül) | 71% | 62% |
| AI-botok szabályozása | Legalább egy AI-crawler nevesítve van | 20% | 100% |
| AI-botok szabályozása | A klasszikus keresőbotok nincsenek kizárva | 100% | 93% |
| AI-botok szabályozása | Van llms.txt | 0% | 0% |
Két dolgot érdemes tudni a pontozásról. Az llms.txt senkinél nem ér pontot, a rangsort nem mozgatja, az átlagokat egyformán nyomja le. Azért hagytam benne, mert a hiánya önmagában is adat. A „keresőbotok nincsenek kizárva” kérdés pedig a klasszikus keresőbotokra (Googlebot, Bingbot) vonatkozik, nem az AI-keresők botjaira, azokról külön fejezet szól. AI-szabálynak azt számoltam, ha a robots-fájl kifejezetten nevesít legalább egy ismert AI-bejárót a 26 figyelt névből, akár tiltva, akár engedve. Az általános tiltás nem számít AI-bot-szabályozásnak.
A két szám, ami tényleg számít
Technikai alapokban a magyar átlag 5,4 pont a hétből, a nemzetközi 5,5. Ennyi a különbség, egy tized. A hét kérdésből háromban a magyar mezőny jobb (működő sitemap, szabványhely, friss lastmod), háromban rosszabb (Sitemap-sor, szabályos robots-fájl, hír-sitemap), egyben azonos. Ebből nem lehet lemaradást kiolvasni, és nem is kell.
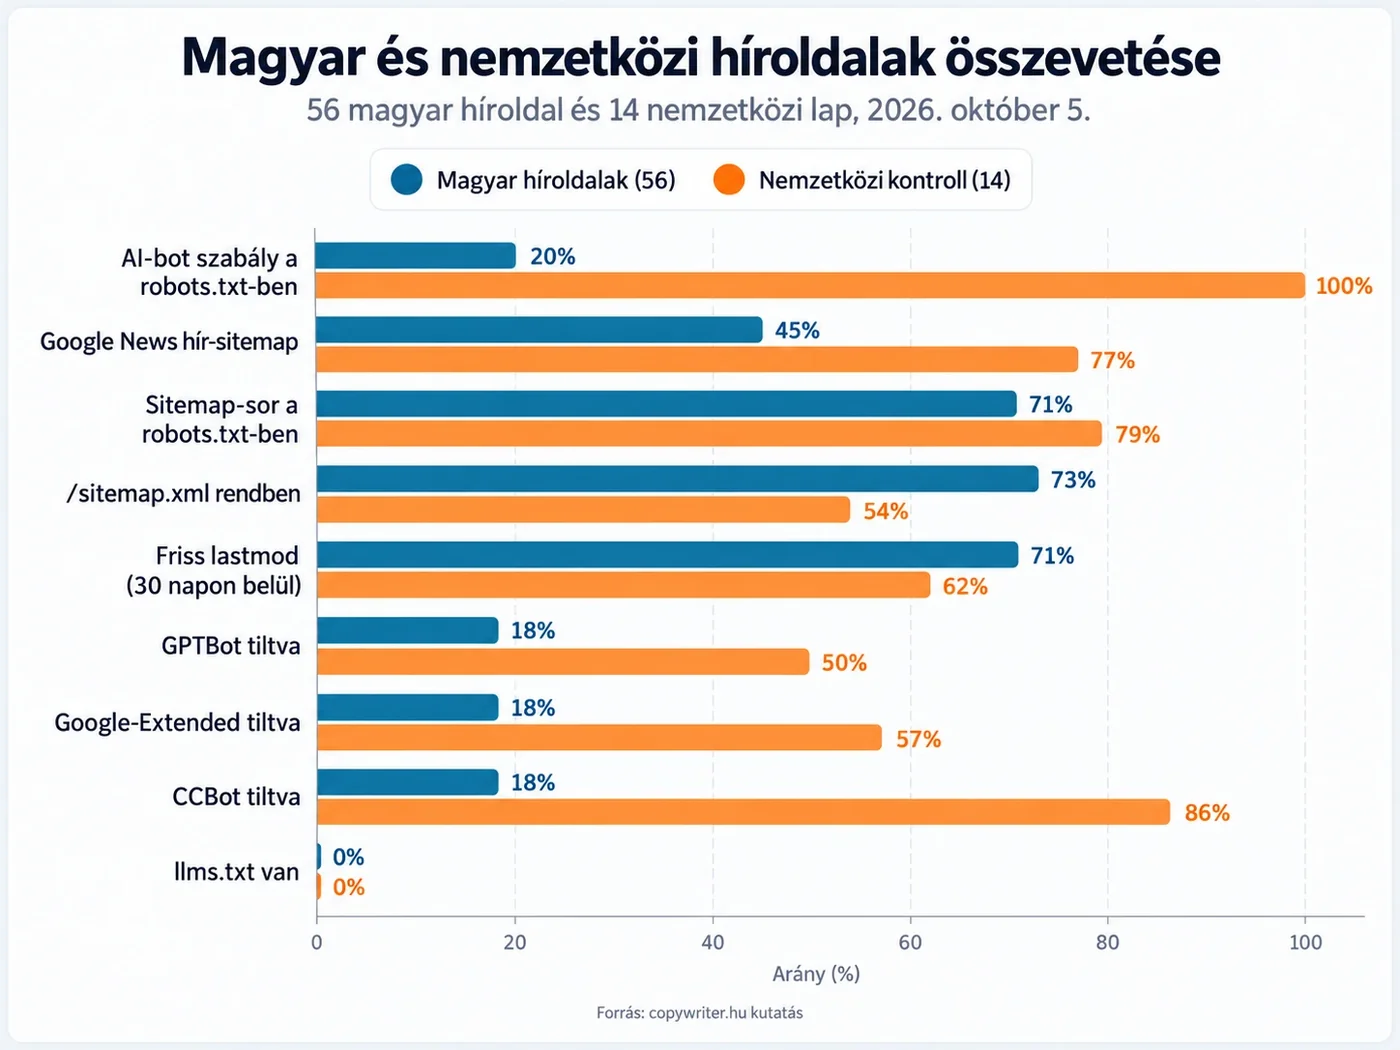
Az első szám, ami számít: a 14 nemzetközi lapból 14 nevesít legalább egy AI-botot a robots.txt fájljában. A legtöbbjük tizennégy és huszonnégy közötti számút, a Reuters mindössze hármat. A magyar mintában 11 oldal csinálja ezt, 45-nél egyetlen ismert AI-crawlerre sincs szabály. Pontosan fogalmazok: ebből annyi következik, hogy a nyilvános robots-fájlból nem derül ki semmilyen AI-bot-szabályozás. Hogy tanítanak-e rajtuk modelleket, és van-e valahol szerződés vagy más technikai korlát, azt a fájl nem mondja meg, és én sem állítom. Annyit állítok, hogy 45 kiadó a nyilvánosság felé nem mondott semmit.
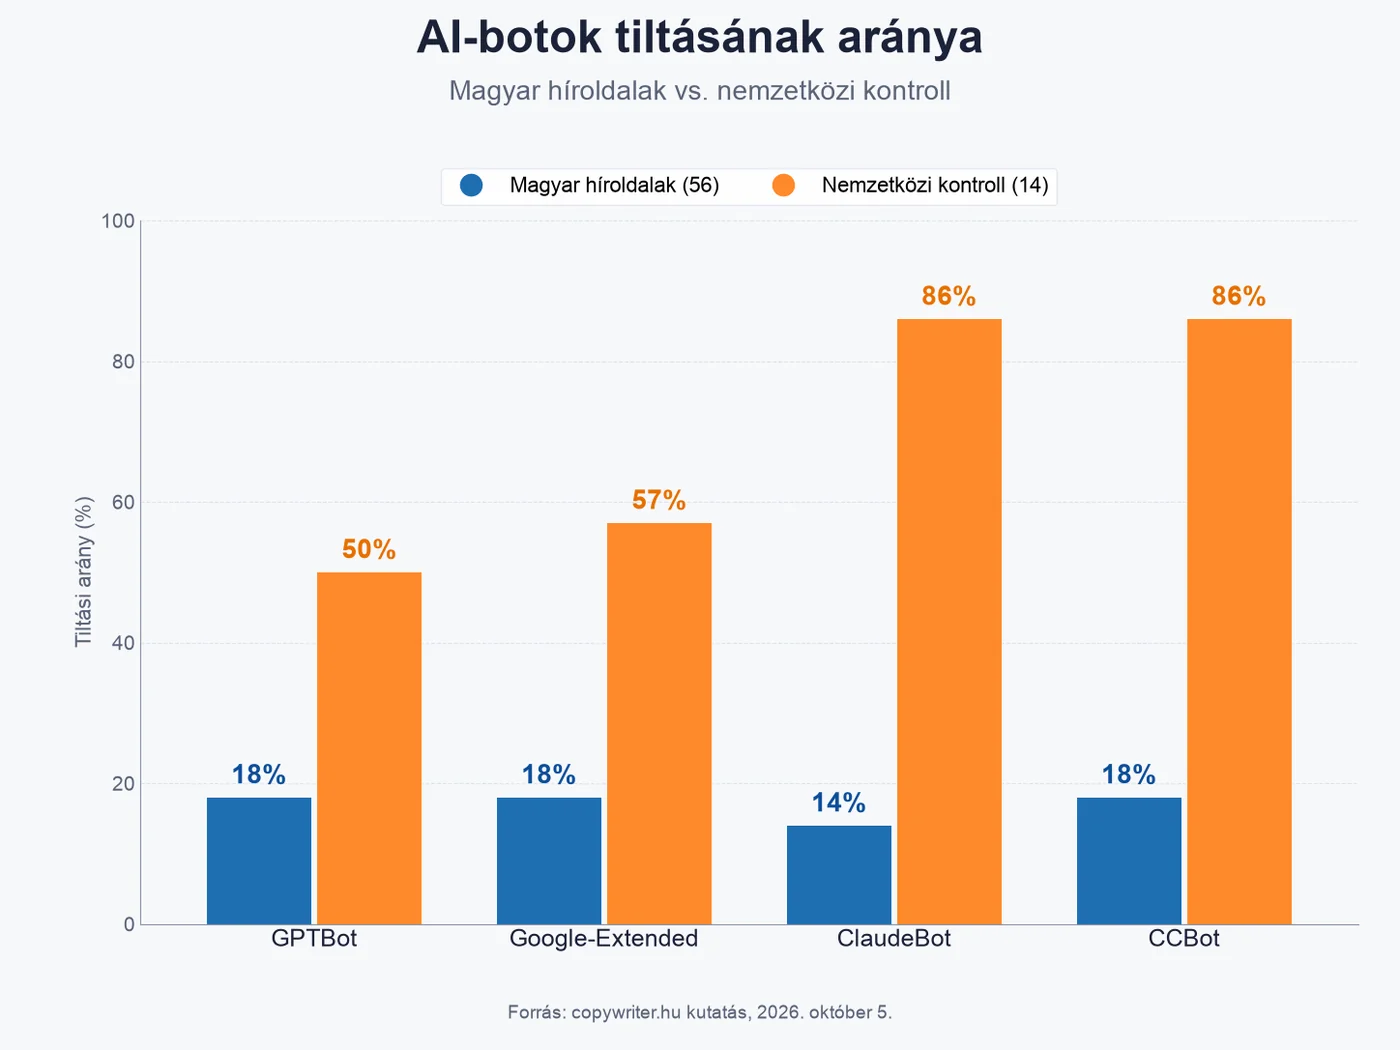
Ami viszont érdekes: a nemzetközi lapok sem egységesek. A GPTBotot csak a felük tiltja, a Common Crawl botját és a ClaudeBotot 86 százalékuk, és 14-ből 13 lap legalább egy keresőbotot vagy idéző botot is kizár, a New York Times például az OAI-SearchBotot is. Szóval nem a tiltás a norma. A kimondott döntés a norma. A Reuters Institute 2023 végén tíz ország vezető híroldalain 48 százalékos OpenAI-tiltást mért, mi most, közel három évvel később 18 százaléknál tartunk, és közben a nemzetközi mintában már mindenki döntött valamit.
A második szám a hír-sitemap: 77 százalék a nemzetközi mezőnyben, 45 a magyarban. Ez nem AI-kérdés. Ez a friss cikk leggyorsabb útja a Google-hoz, és 31 magyar oldal ezt kizárólag a belső linkelésre és a Google saját logikájára bízza. Forgalmat nem mértem, úgyhogy nem mondom, hogy ennyit meg annyit veszítenek. Azt mondom, hogy egy híroldalnál a hiánya feleslegesen nehezíti a friss tartalom gyors feldolgozását, és egy hét alatt megoldható.
Hibák, hiányosságok és néhány gyöngyszem, név szerint
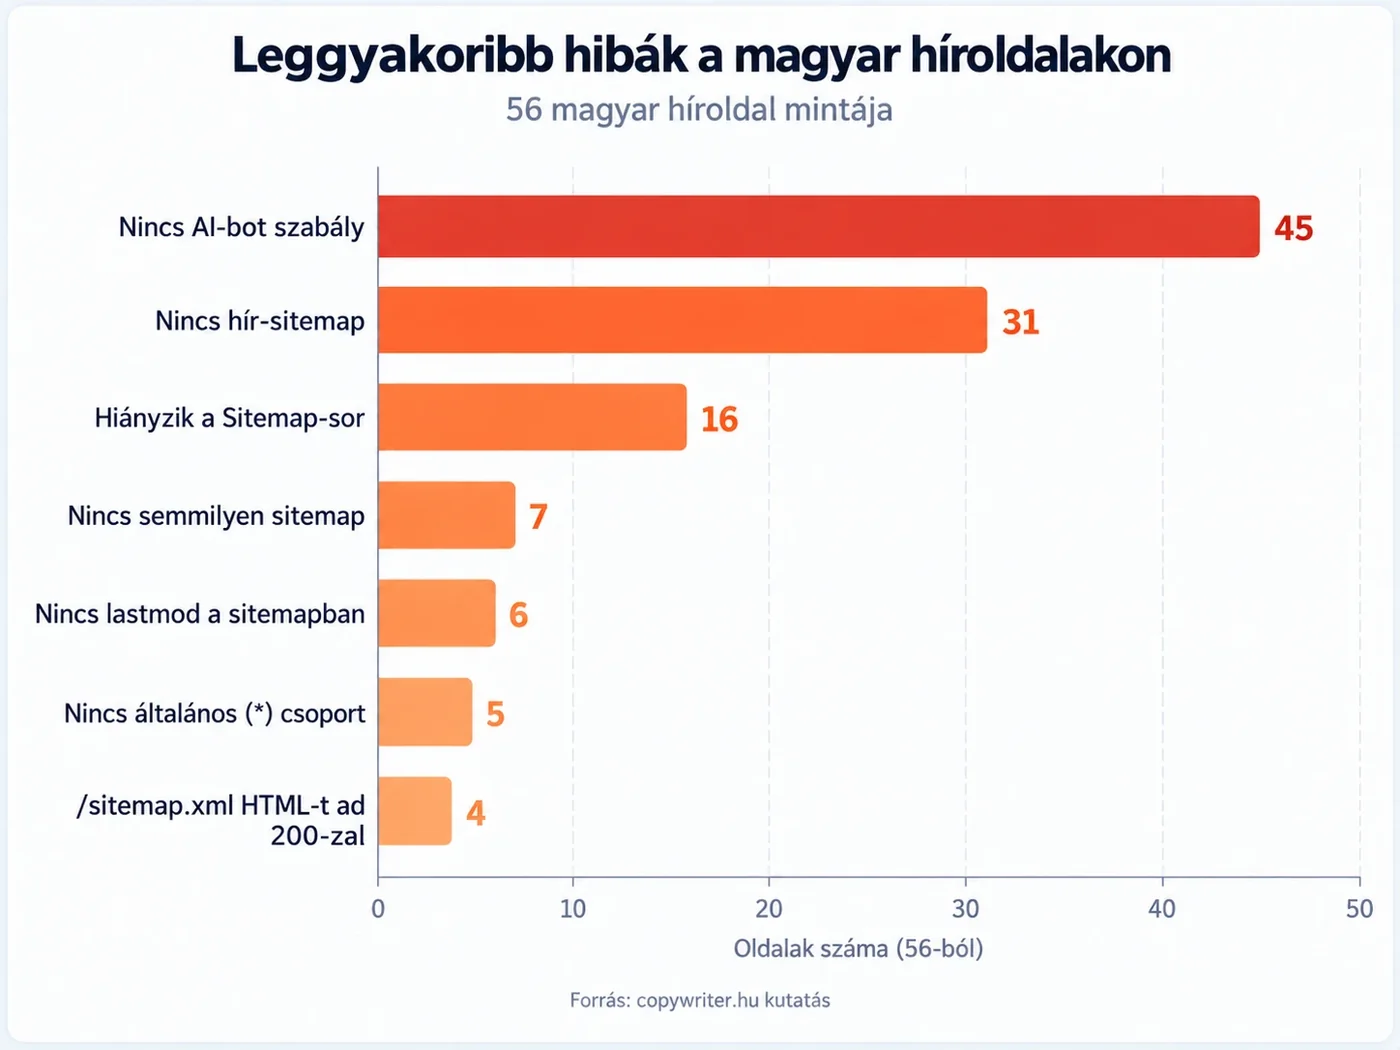
A rangsor a magyar mintában: 45 oldalon nincs szabály AI-crawlerekre, 31-en nincs hír-sitemap, 16 robots.txt fájlból hiányzik a Sitemap-sor, 7 oldalon semmilyen sitemap nem található, 6 sitemapban nincs lastmod, 5 oldalon nincs általános crawler-szabálycsoport, 4 oldalon a /sitemap.xml egy HTML-oldalt ad 200-as kóddal, 3 oldalon a Sitemap-sor http-s címre mutat, 3 oldalon ismeretlen útvonalra 400 vagy 200 jön 404 helyett. Az általános csoport hiánya önmagában nem hiba, a botok enélkül is bejárhatják az oldalt, inkább rendetlenség, ami jellemzően a többi hiánnyal együtt jár.
index.hu. A robots.txt-je tartalmilag rendben van, sőt kilenc AI-botot név szerint tilt, ami itthon ritkaság. Csak éppen text/html fejléccel érkezik, a Sitemap-sor pedig a http://index.hu címre mutat, ami 302-vel ugrik át https-re. Két fejlécsor a szerveren, tíz perc. Utána a legnagyobb magyar hírportál hibalistáján egyetlen tétel maradna, a hiányzó hír-sitemap. A sitemapindex egyébként példás: 292 részfájl 1999-től máig, friss lastmoddal.
telex.hu és g7.hu. A robots-fájl két sor. Egyetlen csoport, a facebookexternalhit botnak, hogy mindent láthasson. Nincs általános csoport, nincs Sitemap-sor, a /sitemap.xml 405-öt ad JSON-nal, mert az API-réteg kapja el a kérést. A hír-sitemap létezik a /sitemap/news.xml címen, csak semmi nem mutat rá. Ugyanaz a fejlesztői kézjegy mindkét oldalon, és mindkettőt a Search Console-beli kézi beküldés tartja életben. Lastmod egyik hír-sitemapban sincs.
mandiner.hu, vg.hu, pestisracok.hu. Azonos platformon futnak, és a /sitemap.xml címre mindhárom egy véletlenszerű cikket ad vissza. Teljes HTML, 800 kilobájt, 200-as kód. (Megnéztem háromszor, mindig másik cikk jött.) A robots-fájlban deklarált sitemapok működnek, de a szabványhely hibás végpont, ami minden ellenőrző eszközt félrevezet, és szükségtelen lekéréseket okoz.
hvg.hu. Meglepő módon egyáltalán nincs sitemapja. Sem a robots.txt nem mutat rá, sem a húsz leggyakoribb útvonal egyikén nem találtam. Egy országos hetilap online kiadása 2026-ban teljes egészében a belső linkelésre bízza, hogy a Google észrevegye az új cikkeket. Ugyanebben a csoportban van az infostart.hu, az mfor.hu, a privatbankar.hu, a ma.hu, a hirklikk.hu és a maszol.ro.
hirado.hu. A robots-fájl 24 bájt: mindent enged, semmit nem mond. A sitemapindex a szabványhelyen van, 731 részfájllal, de a részfájlok címei részben még http-vel kezdődnek.
444.hu. Egyetlen sitemapot deklarál, a hír-sitemapot 82 URL-lel, lastmod nélkül. A tízéves archívumra semmi. Ha a Google egy régi cikket újra be akar járni, azt kizárólag a belső linkeken keresztül találja meg.
nyugat.hu, atv.hu, pestisracok.hu. A nyugat.hu sitemapjának legfrissebb lastmod-értéke 2022. decemberi, az atv.hu-é 2026. májusi (1667 részfájl, azóta nem mozdult), a pestisracok.hu deklarált sitemapjaié 2025. júliusi. Ha a lastmod nem igaz, a Google figyelmen kívül hagyja, és a sitemap elveszti a legfőbb értékét, a változásjelzést.
24.hu. A robots-fájl tiltja az utm_, fbclid és gclid paraméteres URL-eket. Elavult gyakorlat: a tiltott URL canonical-címkéjét a Google nem látja, így nem tudja összevonni az oldalakat, és a tiltott URL akár cím nélkül is indexbe kerülhet. Erre a canonical és a paraméterkezelés való, nem a tiltás.
hang.hu, 168.hu, hirstart.hu. Ismeretlen útvonalra (például /llms.txt) a hang.hu és a 168.hu 400 Bad Requestet ad, a hirstart.hu 200-zal a főoldalt. Egyik sem az llms.txt-ről szól, hanem arról, hogy a szerver nem ad tiszta 404-et, ami minden SEO-eszközben soft-404-figyelmeztetés.
blikk.hu. Három sitemapja az ocdn.eu tartalomszolgáltató címén lóg, http-előtaggal. A Google szabályai szerint ez működik, a robots-fájlból más hosztra mutató sitemap is érvényes. A sitemap-infrastruktúra így viszont egy külső hoszt elérhetőségétől és átirányításaitól függ.
A tizenegy, amelyik döntött. A magyar mezőnyben egyetlen sablonból másolt AI-bot-szabályozás fut öt oldalon: a femina.hu, a napi.hu, a divany.hu, a totalcar.hu és az economx.hu betűről betűre azonos, 19 botot tiltó blokkot használ. Az nlc.hu 12, a propeller.hu 18, a hirstart.hu 15 botot nevesít, az index.hu kilencet, az euronews.com tilt hármat és enged négyet, a hirek.sk egyetlen botot nevez meg. Ez a teljes lista. A többi 45 oldal hallgat.
Melyik bot mit csinál?
Itt jön a rész, ami miatt szerintem elmarad a döntés a kiadóknál. Az „AI-bot” szót úgy használjuk, mintha egy dolog lenne. Nem az. Minden nagy AI-cég legalább kétféle, a legtöbb háromféle névvel jár be, és a három név három különböző dolgot csinál a tartalmaddal.
A tanító botok egyszer végigolvassák az archívumot, és beépítik a modellbe. A GPTBot az OpenAI-é, a ClaudeBot az Anthropicé, a Google-Extended a Gemini tanítását és a válaszok alátámasztását vezérli, a meta-externalagent a Metáé, az Applebot-Extended az Apple-é, a Bytespider a ByteDance-é. Külön kategória a CCBot, a Common Crawl botja: ez egy nyílt korpuszt épít, amiből a kisebb modellek zöme tanul, ezért a nemzetközi lapok 86 százaléka tiltja. Ezek a botok soha nem küldenek vissza senkit. Látogatót nem hoznak, a tartalmad viszont beépül a válaszaikba.
A kereső- és idéző botok azért járnak be, hogy a válaszban a te cikked legyen a forrás, linkkel. Az OAI-SearchBot a ChatGPT keresési válaszaihoz indexel, a PerplexityBot a Perplexity válaszaihoz, a Claude-SearchBot a Claude webes kereséséhez. Ezek az AI-korszak Googlebotjai: ha beengeded őket, hivatkozott linket kapsz, ha nem, a válasz elkészül nélküled, csak a versenytárs lesz a forrás.
A felhasználói lekérés a harmadik kategória, és a legtöbb kiadó nem is tud róla. A ChatGPT-User, a Claude-User és a Perplexity-User akkor indul, amikor egy konkrét ember egy konkrét cikket kér be a beszélgetésben. Ez nem automatikus bejárás, az OpenAI dokumentációja szerint a robots-szabályok nem is feltétlenül vonatkoznak rá. Ez a bot maga a látogató, csak nem böngészőből, hanem egy chatablakból érkezik.
A klasszikus keresőbotok külön kategória: a Googlebot a keresés, az AI-összefoglaló és a Discover, a Bingbot a Bing és rajta keresztül a Copilot. Ezek hozzák ma a forgalom túlnyomó részét, a tiltásuk szóba sem jöhet.
| Bot | Kié | Mit csinál | Hoz látogatót? | Mit kezdjünk vele? |
|---|---|---|---|---|
| GPTBot | OpenAI | modelltanításhoz gyűjt | nem | tiltjuk |
| Google-Extended | a Gemini tanítása és a válaszok alátámasztása | nem | tiltjuk | |
| ClaudeBot | Anthropic | modelltanításhoz gyűjt | nem | tiltjuk |
| CCBot | Common Crawl | nyílt korpuszt épít, ebből tanul a kisebb modellek zöme | nem | tiltjuk |
| Bytespider | ByteDance | modelltanításhoz gyűjt, agresszíven | nem | tiltjuk |
| meta-externalagent, Applebot-Extended | Meta, Apple | modelltanításhoz gyűjt | nem | tiltjuk |
| ChatGPT-User, Claude-User, Perplexity-User | OpenAI, Anthropic, Perplexity | egy felhasználó kérésére kéri le a cikket | igen, közvetlenül: egy ember éppen a te cikkedet olvassa | tűrjük |
| Googlebot, Bingbot | Google, Microsoft | keresés, AI-összefoglaló, Discover, Copilot | igen, ma még ez a legtöbb | tűrjük, soha nem tiltjuk |
| OAI-SearchBot | OpenAI | a ChatGPT keresési válaszaihoz indexel | igen, hivatkozott linkkel | támogatjuk |
| PerplexityBot | Perplexity | válaszokhoz indexel, forrásmegjelöléssel | igen, hivatkozott linkkel | támogatjuk |
| Claude-SearchBot | Anthropic | a Claude webes kereséséhez indexel | igen, hivatkozott linkkel | támogatjuk |
Hogy ez ma mekkora forgalom? A legtöbb kiadónál még az organikus töredéke, és ebben a mérésben nem mértem, úgyhogy számot nem mondok. Megnézni viszont bárki tudja a saját Analyticsében: a chatgpt.com, a perplexity.ai, a claude.ai és a copilot.microsoft.com hivatkozó forgalma külön sorban látszik, a Search Console-ban pedig 2026 augusztusa óta külön jelentés mutatja az AI-összefoglalókból és az AI módból jövő megjelenéseket, erről külön cikkben írtam. Amit a saját ügyfeleimnél látok: ez az a csatorna, ami hónapról hónapra nő, miközben a klasszikus kék linkek kattintásszáma csökken. Aki az idéző botokat tiltja, az pont ebből a növekvő csatornából száll ki.
Tiltjuk, tűrjük, támogatjuk
Ebből jön a három döntés, amit egy kiadónak meg kell hoznia.
Tiltjuk a tanítást. Egy sajtóterméknek nem feltétlenül érdeke, hogy a teljes archívumán ingyen tanuljon bárki, és ezek a botok amúgy sem hoznak olvasót. A tiltás a kiadó szerzői jogi alkupozíciójának része, nem technikai kérdés: aki tilt, az tárgyalhat, aki nem tilt, az már ingyen odaadta. A Google-Extended körül él egy félreértés, amit itt letudok: a tiltásával nem esel ki a Google-keresésből és az AI-összefoglalóból sem, mert azokhoz a Googlebot jár be. Ha az AI-összefoglalóból akarsz részben kimaradni, arra a max-snippet és a nosnippet jelölés való, nem a robots-fájl.
Tűrjük a felhasználói lekérést. A ChatGPT-User és társai nem automatikus bejárók, külön tiltani őket olyan, mintha egy olvasótól vennéd el a linket. A Googlebotot és a Bingbotot pedig nyilván tűrjük, sőt.
Támogatjuk az idézést. Az OAI-SearchBot, a PerplexityBot és a Claude-SearchBot azért jár be, hogy a válaszban a te lapod legyen a forrás. Beengedni, és hír-sitemappal, tiszta cikkoldallal, rendes címekkel segíteni. Hogy a nemzetközi lapok egy része mégis tiltja őket, az üzleti döntés: a New York Times perben áll az OpenAI-jal, és annak minden botját kizárja, a FAZ és a Spiegel szintén tilt idéző botokat. Ez is döntés, csak kimondott, és mögötte licencszerződés vagy per áll. Egy magyar kiadónak, amelyiknek egyik sincs, az idéző botok tiltása csak lemondás a forgalomról.
Egy sajtóterméknek szánt minta robots.txt, amit be lehet másolni:
User-agent: *
Disallow: /admin/
Disallow: /szerk/

# tiltjuk: tanító botok
User-agent: GPTBot
User-agent: Google-Extended
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Bytespider
User-agent: meta-externalagent
User-agent: Applebot-Extended
Disallow: /

# támogatjuk: kereső- és idéző botok
User-agent: OAI-SearchBot
User-agent: PerplexityBot
User-agent: Claude-SearchBot
Allow: /

Sitemap: https://www.pelda.hu/sitemap.xml
Sitemap: https://www.pelda.hu/sitemap-news.xml
És egy minta hír-sitemap, mert ezt is sokan rosszul csinálják:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"
        xmlns:news="http://www.google.com/schemas/sitemap-news/0.9">
  <url>
    <loc>https://www.pelda.hu/belfold/2026/10/05/cikk-cime</loc>
    <lastmod>2026-10-05T08:42:00+02:00</lastmod>
    <news:news>
      <news:publication>
        <news:name>Példa Hírportál</news:name>
        <news:language>hu</news:language>
      </news:publication>
      <news:publication_date>2026-10-05T08:40:00+02:00</news:publication_date>
      <news:title>A cikk címe pontosan úgy, ahogy az oldalon</news:title>
    </news:news>
  </url>
</urlset>
Percenként frissül, a lastmod a tényleges utolsó módosítás. Az archívum külön sitemapindexbe megy, fájlonként legfeljebb 50 000 URL és 50 megabájt.
Az llms.txt: nulla mindenhol, és ez így van jól
Az llms.txt körül másfél éve nagy a zaj. SEO-eszközök gyártanak hozzá generátort, ügynökségek árulják az „AI-optimalizálás” kötelező elemeként. A mérésben a 70 oldalból egynek sincs. Sem a Telexnek, sem a New York Timesnak. A Google 2026 júniusában hivatalosan is tisztázta, hogy a kereséshez nem kell, és a láthatóságra se pozitív, se negatív hatása nincs. A nagy kereső- és AI-szolgáltatóknál nem találtam olyan hivatalos dokumentációt, amely érdemi láthatósági tényezőként írná le. Itt tehát nincs lemaradás. Ugyanott állunk, ahol a világ legnagyobb lapjai.
Ami jó belőle, az a gondolat: legyen géppel olvasható jelzése az oldalnak arról, mit enged és mit nem. Erre már van két újabb, a robots-fájlba illeszkedő kezdeményezés, és a nemzetközi kontrollcsoport egy része használja is. A Guardian és a Bild License-sorral mutat egy géppel olvasható licencfájlra (RSL-formátum), a Corriere Content-Signal-sorral jelzi, hogy keresésre igen, AI-válaszba igen, tanításra nem. Mindkettő új, nem általánosan támogatott konvenció, inkább nyilatkozat, mint lakat, de ezek mutatják, merre megy a piac: a kiadó géppel olvashatóan kimondja, mit enged. Magyar oldalon egyik sincs. Az llms.txt 15 perc és nulla kockázat, csak ne ezzel kezdd.
Mit lehet tenni?
A fejlesztő csapat viszonylag gyorsan rendbe teheti a robots.txt-t: általános csoport, text/plain fejléc, https-es Sitemap-sor minden sitemapra, a /sitemap.xml adjon XML-t vagy 301-et a valódi sitemapindexre, ismeretlen útvonalra tiszta 404. A másik, aminek érdemes nekiállni: megcsinálni a hír-sitemapot az utolsó 48 óra cikkeivel, valós lastmoddal, mellé a sitemapindexet az archívumra. És érdemes végigmenni a fenti bot-táblázaton vezetői és fejlesztői szinten, hogy botonként kimondjuk a tiltjukot, a tűrjüköt vagy a támogatjukot. Utána tíz-tizenöt sor a fájlban, és a lap végre azt mondja a gépeknek, amit mi akarunk.
És ha kíváncsi vagy, hogy mindez után mit mond rólad a ChatGPT, a Gemini és a Perplexity, mikor említ, mikor hivatkozik rád, és kit ajánl helyetted, arra való az AI-láthatóság mérése. Ott pontosan ezt mérjük meg a te lapodon, és a végén nem egy riportot kapsz, hanem egy listát, hogy mit csinálj. Kiadóknak, szerkesztőségeknek külön is összeraktuk, mit tudunk segíteni.
Melléklet: a teljes táblázat, mind a 70 oldal
Pont: 0-tól 10-ig. Sitemap-sor: a robots.txt-ben deklarált sitemapok száma. /sitemap.xml: a szabványhely válasza. AI-szabály: hány AI-bot van kifejezetten nevesítve (tiltva vagy engedve). A sorok csoporton belül pontszám szerint állnak.
| Domain | robots.txt | Sitemap-sor | /sitemap.xml | Hír-sitemap | lastmod | AI-szabály | llms.txt | Pont |
|---|---|---|---|---|---|---|---|---|
| euronews.com | 200 | 13 db | 404, robots mutat | igen | 2026-10-05 | 3 tiltva / 4 engedve | 404 | 9 |
| boon.hu | 200 | 1 db | 404, robots mutat | igen | 2026-10-05 | nincs | 404 | 8 |
| borsonline.hu | 200 | 1 db | 200 XML | igen | 2026-10-05 | nincs | 404 | 8 |
| delmagyar.hu | 200 | 1 db | 404, robots mutat | igen | 2026-10-05 | nincs | 404 | 8 |
| divany.hu | 200 | 1 db | 404, robots mutat | nem | 2026-10-05 | 19 tiltva / 7 engedve | 404 | 8 |
| economx.hu | 200 | 1 db | 404, robots mutat | nem | 2026-10-05 | 19 tiltva / 7 engedve | 404 | 8 |
| femina.hu | 200 | 1 db | 404, robots mutat | nem | 2026-10-05 | 19 tiltva / 7 engedve | 404 | 8 |
| haon.hu | 200 | 1 db | 404, robots mutat | igen | 2026-10-05 | nincs | 404 | 8 |
| hirtv.hu | 200 | 2 db | 404, robots mutat | igen | 2026-10-05 | nincs | 404 | 8 |
| index.hu | 200 · text/html | 1 db · http:// | 404, robots mutat | nem | 2026-10-05 | 9 tiltva | 404 | 8 |
| kisalfold.hu | 200 | 1 db | 404, robots mutat | igen | 2026-10-05 | nincs | 404 | 8 |
| life.hu | 200 | 1 db | 404, robots mutat | igen | 2026-10-05 | nincs | 404 | 8 |
| magyarnemzet.hu | 200 | 1 db | 404, robots mutat | igen | 2026-10-05 | nincs | 404 | 8 |
| metropol.hu | 200 | 1 db | 404, robots mutat | igen | 2026-10-05 | nincs | 404 | 8 |
| napi.hu | 200 | 1 db · más hoszt | 404, robots mutat | nem | 2026-10-05 | 19 tiltva / 7 engedve | 404 | 8 |
| nepszava.hu | 200 | 1 db | 200 XML | igen | 2026-10-05 | nincs | 404 | 8 |
| nlc.hu | 200 | 1 db | 200 XML | nem | 2026-10-05 | 12 tiltva | 404 | 8 |
| origo.hu | 200 | 2 db | 200 XML | igen | 2026-10-05 | nincs | 404 | 8 |
| penzcentrum.hu | 200 | 1 db | 404, robots mutat | igen | 2026-10-05 | nincs | 404 | 8 |
| portfolio.hu | 200 | 3 db | 404, robots mutat | igen | 2026-10-05 | nincs | 404 | 8 |
| propeller.hu | 200 | 1 db · http:// | 200 XML | nem | 2026-10-05 | 18 tiltva | 404 | 8 |
| ripost.hu | 200 | 2 db | 404, robots mutat | igen | 2026-10-05 | nincs | 404 | 8 |
| startlap.hu | 200 | 1 db | 200 XML | igen | 2026-10-05 | nincs | 404 | 8 |
| story.hu | 200 | 4 db | 404, robots mutat | igen | 2026-10-04 | nincs | 404 | 8 |
| totalcar.hu | 200 | 1 db | 404, robots mutat | nem | 2026-10-04 | 19 tiltva / 7 engedve | 404 | 8 |
| vezess.hu | 200 | 1 db | 200 XML | igen | 2026-10-05 | nincs | 404 | 8 |
| 168.hu | 200 | 1 db | 200 XML | nem | 2026-10-05 | nincs | 400 | 7 |
| 24.hu | 200 | 1 db | 200 XML | nem | 2026-10-05 | nincs | 404 | 7 |
| 444.hu | 200 | 1 db | 404, robots mutat | igen | nincs lastmod | nincs | 404 | 7 |
| blikk.hu | 200 | 9 db · http:// · más hoszt | 404, robots mutat | nem | 2026-10-04 | nincs | 404 | 7 |
| demokrata.hu | 200 | 1 db | 404, robots mutat | nem | 2026-10-02 | nincs | 404 | 7 |
| hang.hu | 200 | 1 db | 200 XML | nem | 2026-10-05 | nincs | 400 | 7 |
| hirstart.hu | 200 | 1 db | HTML (soft 404) | nem | 2026-10-05 | 15 tiltva | 200 HTML | 7 |
| merce.hu | 200 | 1 db | 200 XML | nem | 2026-10-05 | nincs | 404 | 7 |
| qubit.hu | 200 | 1 db | 404, robots mutat | igen | nincs lastmod | nincs | 404 | 7 |
| vg.hu | 200 | 1 db | HTML (soft 404) | igen | 2026-10-05 | nincs | 404 | 7 |
| atv.hu | 200 | 1 db | 200 XML | nem | 2026-05-12 | nincs | 404 | 6 |
| forbes.hu | 200 | nincs | 200 XML | nem | 2026-10-04 | nincs | 404 | 6 |
| hazipatika.com | 200 | nincs | 200 XML | nem | 2026-10-04 | nincs | 404 | 6 |
| hirado.hu | 200 | nincs | 200 XML | nem | 2026-10-05 | nincs | 404 | 6 |
| hirek.sk | 200 | nincs | 404 | igen | nincs lastmod | 1 engedve | 404 | 6 |
| mandiner.hu | 200 | 1 db | HTML (soft 404) | nem | 2026-10-05 | nincs | 404 | 6 |
| pestisracok.hu | 200 | 2 db | HTML (soft 404) | igen | 2025-07-08 | nincs | 404 | 6 |
| rtl.hu | 200 | nincs | 200 XML | nem | 2026-10-05 | nincs | 404 | 6 |
| szeretlekmagyarorszag.hu | 200 | 1 db | nem válaszol | nem | 2026-09-16 | nincs | 404 | 6 |
| nyugat.hu | 200 | nincs | 200 XML | nem | 2022-12-05 | nincs | 404 | 5 |
| g7.hu | 200 · nincs * csoport | nincs | 405 | igen | nincs lastmod | nincs | 404 | 4 |
| telex.hu | 200 · nincs * csoport | nincs | 405 | igen | nincs lastmod | nincs | 404 | 4 |
| valaszonline.hu | 200 · nincs * csoport | nincs | 200 XML | nem | nincs lastmod | nincs | 404 | 4 |
| hirklikk.hu | 200 | nincs | 404 | nem | nincs sitemap | nincs | 404 | 3 |
| hvg.hu | 200 | nincs | 404 | nem | nincs sitemap | nincs | 404 | 3 |
| infostart.hu | 200 | nincs | 404 | nem | nincs sitemap | nincs | 404 | 3 |
| ma.hu | 200 | nincs | 404 | nem | nincs sitemap | nincs | 404 | 3 |
| maszol.ro | 200 | nincs | 404 | nem | nincs sitemap | nincs | 404 | 3 |
| mfor.hu | 200 · nincs * csoport | nincs | 404 | nem | nincs sitemap | nincs | 404 | 2 |
| privatbankar.hu | 200 · nincs * csoport | nincs | 404 | nem | nincs sitemap | nincs | 404 | 2 |
| bild.de | 200 · License | 4 db | 404, robots mutat | igen | 2026-10-05 | 14 tiltva | 404 | 9 |
| lemonde.fr | 200 | 4 db | 404, robots mutat | igen | 2026-10-05 | 19 tiltva | 200 HTML | 9 |
| theguardian.com | 200 · License | 2 db · http:// | 404, robots mutat | igen | 2026-10-05 | 14 tiltva | 404 | 9 |
| bbc.com | 200 | 39 db | 200 XML | nem | 2026-10-05 | 19 tiltva | 404 | 8 |
| corriere.it | 200 · Content-Signal | 65 db | HTML (soft 404) | igen | 2026-10-05 | 14 tiltva / 2 engedve | 404 | 8 |
| ft.com | 200 | 1 db | 404, robots mutat | igen | 1997-07-19 (helyőrző) | 15 tiltva | 404 | 8 |
| nytimes.com | 200 | 25 db | 403 | igen | 2026-10-05 | 23 tiltva / 1 engedve | 404 | 8 |
| spiegel.de | 200 | 4 db | 200 XML | igen | 2007-04-30 (helyőrző) | 22 tiltva | 404 | 8 |
| zeit.de | 200 | 1 db | 200 XML | igen | nincs lastmod | 14 tiltva | 404 | 8 |
| faz.net | 200 | nincs | 404 | igen | 2026-10-05 | 24 tiltva | 404 | 7 |
| reuters.com | 200 | 14 db | 401 | igen | 2026-10-05 | 1 tiltva / 2 engedve | 401 | 7 |
| elpais.com | 200 | nincs | 404 | nem | nincs sitemap | 10 tiltva | 404 | 4 |
| sueddeutsche.de | 200 | nincs | HTML (soft 404) | nem | nincs sitemap | 8 tiltva / 1 engedve | 200 HTML | 4 |
| washingtonpost.com | 200 | 7 db | n. m. | n. m. | n. m. | 13 tiltva | n. m. | n. m. |
Pont: 0-tól 10-ig. Sitemap-sor: a robots.txt-ben deklarált sitemapok száma. /sitemap.xml: a szabványhely válasza. AI-szabály: hány AI-bot van kifejezetten nevesítve (vidd rá az egeret a listához). n. m. = nem mérhető, a Washington Post sitemapjait a botvédelem nem adta ki. Helyőrző: a sitemapban közölt lastmod nyilvánvalóan nem valódi dátum (ft.com 1997, spiegel.de 2007).
Korlátok és források
Egyszeri mérés, egy napon, böngésző user-agenttel; egy CDN-hiba vagy pillanatnyi botvédelem torzíthat. A sitemapindexekből mintát vettem, az URL-számok alsó becslések. Hír-sitemapnak a Google News névtérrel ellátott sitemapot fogadtam el; ha egy kiadó csak a Search Console-ba küldi be nem publikus címen, azt nem látom. A robots.txt szabályait semmi nem kényszeríti ki, a botok önként tartják be, ezért a mérés azt mutatja, mit deklarál nyilvánosan egy kiadó, nem azt, hogy a tartalmát ténylegesen mire használják. A License- és Content-Signal-sorokat nem hibának, hanem új direktívának számoltam.
Külső források: Reuters Institute: How many news websites block AI crawlers? (2024. február, 2023 végi adat); OpenAI bot-dokumentáció (GPTBot, OAI-SearchBot, ChatGPT-User); Google Search Central: News sitemaps, Google crawlers, robots.txt specifikáció, Search updates (2026. június, llms.txt); Cloudflare Content Signals Policy; Really Simple Licensing; Answer.AI llms.txt javaslat. A nyers adatok és a mérőszkript kérésre elérhetők.